
對話00:27
00:00
00:27
雙主持人 Podcast
一句提示詞,讓對話帶出情感,讓配樂、環境聲與音效共同營造故事氛圍。免費體驗聲音創作。
單次生成長度
讓對話與情節在更完整的場景中展開。
段參考音訊
透過多段錄音引導不同角色的聲音表現。
種語言與地區變體
為不同地區的聽眾創作貼近語境的對話。
種輸入組合
從文字開始,也能搭配音訊與影片。
從腳本到完整聲音場景
SeedAudio 1.5 是 ByteDance 音訊創作模型的最新演進,專為完整聲音場景而設計。它能在同一創作流程中生成對話、音樂、環境聲與音效,並在 1.0 的基礎上支援更長的輸出、更多聲音參考與影片引導輸入,同時提供獨立音軌,方便後製。
撰寫提示詞時,先交代誰在說話、身處何處,以及場景中會發生什麼變化。生成後,你可以將各層聲音匯入編輯器,分別調整音量與層次,無須為了修改一處細節重新生成整個場景。
把創作想法寫進提示詞
寫清楚哪些聲音需要被聽見,哪些只需在背景中襯托氣氛。
先介紹說話的角色,再描述房間、背景聲與配樂。隨著對話推進,讓場景氛圍保持連貫。
單次最長 6 分鐘,可以在同一份提示詞中安排開場、轉折與收尾,讓場景有完整的起伏。
最多使用 6 段參考錄音,引導聲線與表達方式。請清楚標示每段錄音對應的角色,讓聲音分配更明確。
涵蓋 30 種語言與地區變體。註明語言、口音與目標聽眾,讓對話更符合故事發生的地方。
平穩的語速、猶豫的回答,或開口前的一聲輕笑,都能寫進提示詞。具體的表演指示比籠統的情緒標籤更有幫助。
標出人聲、音效或音樂預期進入的時間。先用它確立創作方向,再透過四條獨立音軌微調時機。
多種輸入方式
依現有素材選擇輸入方式:寫好的腳本、想參考的聲音,或等待配音的影片。
當腳本與聲音描述已足夠完整時,直接用文字交代整個場景。
聲音場景當你有想參考的聲線或表達方式時,加入錄音來引導聲音表現。
聲音場景當畫面已經確定時,透過影片提供場景環境與可見的動作。
聲音場景同時提供畫面與參考錄音,讓場景線索與聲音表現都有依據。
聲音場景寫清楚場景需求、試聽生成結果,再於編輯器完成最後的節奏調整。
交代每位角色的身分並寫好對話,再補充環境與能呈現空間感的聲音。
用錄音引導角色聲音,用影片交代畫面。說明每份素材需要參考的部分。
描述角色的表達方式,提示音效與配樂何時進入,並在需要時保留停頓。
先檢查台詞與聲音平衡,再透過獨立音軌調整時機、音量與轉場。
配合畫面安排聲音
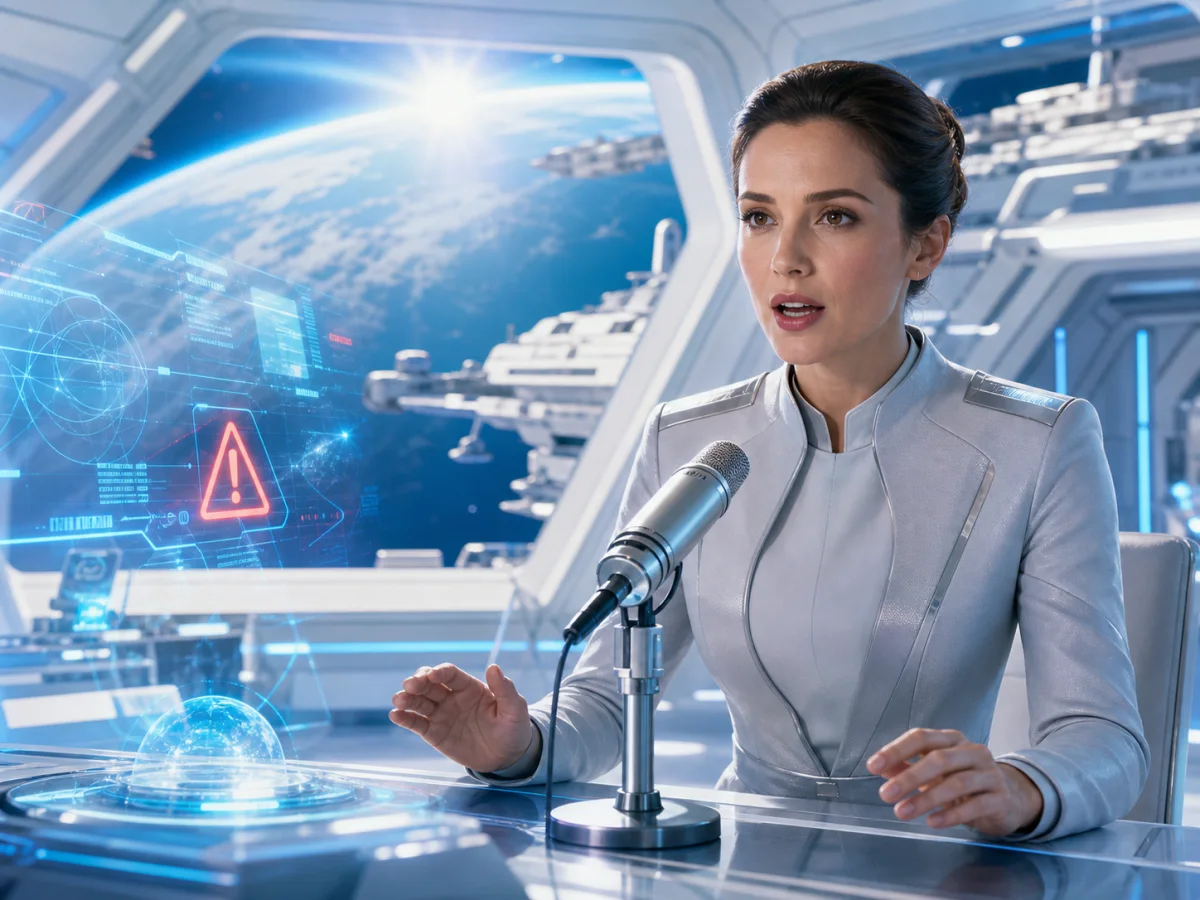
以這個太空船場景為例:先安排機械聲,為領航員的回應保留空間,再帶入輕柔的電子樂節奏。下方時間戳用來提示聲音進入的時機,實際位置可在編輯器中對照影片微調。
繼電器輕響兩聲,背景通風聲持續。
領航員低聲說:「保持位置,等訊號恢復。」
回應結束後,輕柔的合成器節奏漸入,維持人聲清晰。
生成之後,繼續細修
下圖以太空船場景為例,呈現一段 24 秒的分軌編輯構想:為台詞保留空間,讓通風聲貫穿全段,在對話前放入繼電器聲,並在回應後帶入音樂。波形僅用來說明各層聲音的編排,並非實際生成的錄音。
為領航員的回應保留停頓
讓通風聲穩定貫穿整個片段
將繼電器聲安排在台詞之前
在對話結束後帶入合成器節奏
當故事需要完整的聲音
從角色的聲音到四周的動靜,一起構成可信的場景。生成的音訊可以作為下一輪剪輯的起點。
透過環境底聲、人物動作與適度的配樂,為一段對話建立具體的空間。
為開場、故事旁白或情境對話製作初稿。發布前,檢查人名、停頓與表達是否自然。
借助畫面交代環境與動作,再檢查翻譯後的台詞,並在後製時調整對話長度。
確定最終混音前,先嘗試氛圍與音效的組合。保留獨立音軌,方便後續修改。
兩個版本都能創作完整聲音場景。1.5 支援更長的輸出、更多參考音訊、影片輸入與獨立分軌。短場景可選擇 1.0;若需要更長篇幅或更靈活的後製編輯,則可關注 1.5。
| 功能 | Seed Audio 1.5 · 即將推出 | Seed Audio 1.0 |
|---|---|---|
| 單次音訊長度 | 最長 6 分鐘 | 最長 2 分鐘 |
| 參考音訊數量 | 最多 6 段 | 最多 3 段 |
| 語言與地區變體 | 30 種語言與地區變體 | 20 多種語言 |
| 輸入組合 | 文字;文字 + 音訊;文字 + 影片;文字 + 音訊 + 影片 | 文字;文字 + 音訊;文字 + 圖片 |
| 音軌輸出 | 對話、環境聲、音效與音樂獨立分軌 | 多音軌生成被列為後續發展方向 |
| 時間控制 | 以時間戳提示對話、音效、環境聲與音樂的進入時機 | 支援對話時間控制;公開資料提及 100 毫秒間隔 |
了解生成長度、聲音參考、語言支援與商業使用條件。
Seed Audio 1.5 即將推出,本站目前提供 Seed Audio 1.0,並設有有限的免費額度,讓你透過短音訊預覽評估提示詞與聲音表現。更長的輸出與更多使用量依所選方案而定,詳細額度與方案內容請見價格頁面。
1.5 版本支援單次最長 6 分鐘,1.0 版本則為 2 分鐘。較長的篇幅適合連貫對話、故事旁白,以及逐漸變化的聲音場景。建議在提示詞中註明預期長度與段落安排;6 分鐘是上限,不必每次都用滿。
兩個版本都能在完整聲音場景中生成對話。1.5 將單次長度延伸至 6 分鐘,參考音訊從最多 3 段增加至 6 段,涵蓋 30 種語言與地區變體;同時加入影片引導輸入,並將對話、環境聲、音效與音樂分別輸出為獨立音軌。如果只需要較短的場景,也用不到這些新增功能,1.0 仍是合適的選擇。
模型支援以參考音訊引導聲音生成。錄音可協助引導角色聲線、音色、口音與表達方式,文字指令則能進一步調整情緒、風格及語速。這有助於維持同一角色的聲音特色,但不保證精確重現某位真人的聲音。請僅使用你擁有相關權利或已取得授權的參考錄音。
支援範圍涵蓋 30 種語言與地區變體,公開範例包括英語、中文、日語、韓語、德語、法語、墨西哥西班牙語與巴西葡萄牙語。地區變體已計入這 30 種之中,並非額外增加 30 種語言。為特定地區創作對話時,建議清楚註明語言、口音與發音需求。
只要所選方案允許,且使用方式符合服務條款,生成內容即可用於商業專案。你也需要擁有腳本、參考錄音及其他輸入素材的相關使用權。將作品用於廣告、遊戲、影視或其他公開專案前,請確認成品未侵害第三方權利。
不用。文字模式可直接依據文字描述生成場景;搭配參考音訊時,也能在沒有影片的情況下引導角色聲音。只有選擇影片引導模式時才需要上傳影片,由畫面提供場景、動作,以及對話與配樂的相關線索。
寫好台詞、交代場景,再告訴模型:你希望聽眾先聽見什麼。